
问题管理
概述
在当前的功能模块中,我们已经完成了多个核心功能,包括数据库设计、用户登录、知识库管理、文件拆分、片段向量化、命中率测试、文档管理以及片段管理。这些功能为存储、管理和处理数据提供了坚实的基础。
接下来,我们将实现 问题管理 功能,该功能旨在为片段指定问题,为大模型推理提供参考依据。通过问题管理,用户可以更高效地组织和利用知识库中的信息,提高系统的智能化水平。
已完成的核心功能
- 数据库设计:提供结构化的支持,确保片段数据的高效存储与管理。
- 用户登录:确保数据访问和操作的安全性,防止未经授权的访问。
- 知识库管理:支持知识库的创建、更新和删除,方便用户维护知识库内容。
- 文件拆分:将上传的文件拆分为多个片段,便于内容的精细化管理。
- 片段向量化:通过向量化技术,将片段内容转换为可计算的向量,便于进行相似度计算。
- 命中率测试:通过计算用户查询与片段的相似度,评估系统的匹配效果。
- 文档管理:实现对不同文档内容的管理,支持多文档的高效处理。
- 片段管理:实现对不同文档片段的管理,支持片段的增删改查操作。
问题管理功能
功能介绍
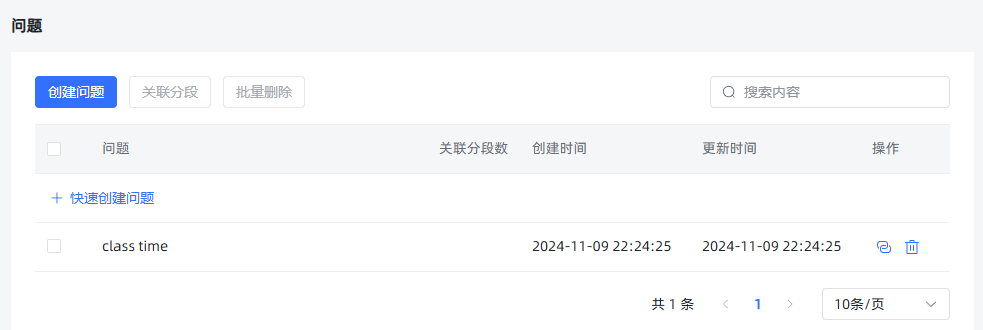
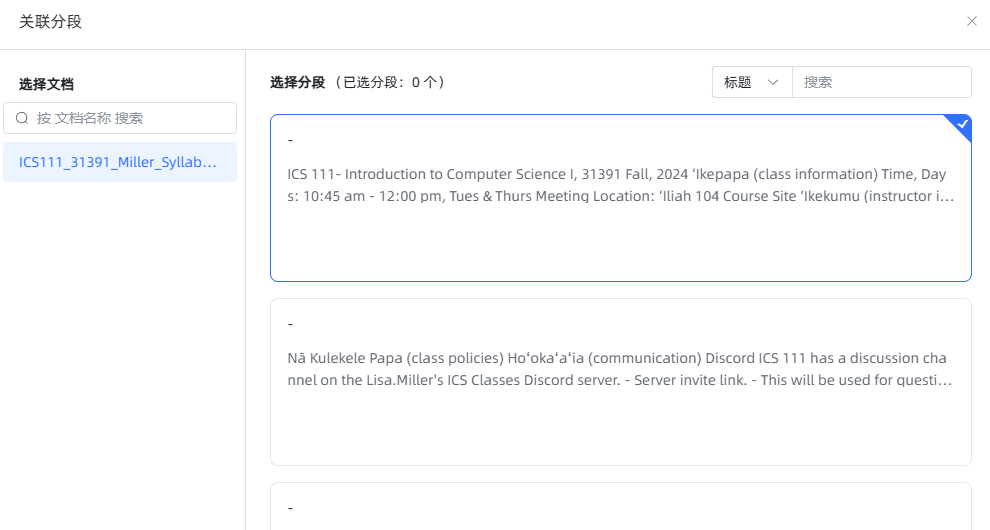
问题管理功能主要用于给知识库中的片段指定相关问题。这些问题将作为大模型推理的参考依据,提升系统的智能化和响应准确性。通过问题管理,用户可以为每个片段关联一个或多个问题,便于后续的数据分析和处理。
接口设计
1. 创建问题
请求方式:
POSTURL:
http://localhost:3000/api/dataset/{datasetId}/problem请求负载:
json["office hour"]响应示例:
json{ "message": null, "data": ["444834872039501824"], "code": 200 }
2. 获取问题列表
请求方式:
GETURL:
http://localhost:3000/api/dataset/{datasetId}/problem/{pageNo}/{pageSize}响应示例:
json{ "message": null, "data": { "size": 10, "total": 2, "records": [ { "tenant_id": "0", "creator": "", "update_time": 1731132193047, "deleted": 0, "create_time": 1731132193047, "dataset_id": "443309276048408576", "id": "444831888056446976", "content": "class time", "hit_num": 0, "updater": "" }, { "tenant_id": "0", "creator": "", "update_time": 1731132904550, "deleted": 0, "create_time": 1731132904550, "dataset_id": "443309276048408576", "id": "444834872039501824", "content": "office hour", "hit_num": 0, "updater": "" } ], "current": 1 }, "code": 200 }
3. 关联问题与段落
请求方式:
PUTURL:
http://localhost:3000/api/dataset/{datasetId}/document/{documentId}/paragraph/{paragraphId}/problem/{problemId}/association请求负载:
json{}响应示例:
json{ "message": null, "data": null, "code": 200 }
4. 取消关联问题与段落
请求方式:
PUTURL:
http://localhost:3000/api/dataset/{datasetId}/document/{documentId}/paragraph/{paragraphId}/problem/{problemId}/un_association响应示例:
json{ "message": null, "data": null, "code": 200 }
5. 批量添加问题与段落的关联
请求方式:
POSTURL:
http://localhost:3000/api/dataset/{datasetId}/problem/_batch请求负载:
json{ "problem_id_list": ["444831888056446976", "444834872039501824"], "paragraph_list": [ { "paragraph_id": "443662146835439616", "document_id": "443662133182980096" } ] }响应示例:
json{ "message": null, "data": null, "code": 200 }
6. 删除单个问题
请求方式:
DELETEURL:
http://localhost:3000/api/dataset/{datasetId}/problem/{problemId}响应示例:
json{ "message": null, "data": null, "code": 200 }
7. 批量删除问题
请求方式:
DELETEURL:
http://localhost:3000/api/dataset/{datasetId}/problem/_batch请求负载:
json["445226726791389184", "445226726791389185"]响应示例:
json{ "message": null, "data": null, "code": 200 }
8. 根据问题 ID 获取关联的段落
请求方式:
GETURL:
http://localhost:3000/api/dataset/{datasetId}/problem/{problemId}/paragraph响应示例:
json{ "message": null, "data": [{ "id": "443662143056371712" }], "code": 200 }
代码实现
以下是问题管理功能的代码实现,包括 API 控制器和服务层。
API 控制器
@RequestPath("/api/dataset")
public class ApiDatasetController {

  @Post("/{datasetId}/problem")
  public ResultVo createProblem(Long datasetId, HttpRequest request) {
    String bodyString = request.getBodyString();
    List<String> problems = JsonUtils.parseArray(bodyString, String.class);
    return Aop.get(MossKbProblemService.class).create(datasetId, problems);
  }

  @Delete("/{datasetId}/problem/_batch")
  public ResultVo deleteProblemBatch(Long datasetId, HttpRequest request) {
    String bodyString = request.getBodyString();
    List<Long> problems = JsonUtils.parseArray(bodyString, Long.class);
    return Aop.get(MossKbProblemService.class).delete(datasetId, problems);
  }

  @Get("/{datasetId}/problem/{pageNo}/{pageSize}")
  public ResultVo pageDatasetProbleam(Long datasetId, Integer pageNo, Integer pageSize) {
    return Aop.get(MossKbProblemService.class).page(datasetId, pageNo, pageSize);
  }

  @Get("/{datasetId}/problem/{problemId}/paragraph")
  public ResultVo listParagraphByProblemId(Long datasetId, Long problemId) {
    return Aop.get(MossKbProblemService.class).listParagraphByProblemId(datasetId, problemId);
  }

  @Put("/{datasetId}/document/{documentId}/paragraph/{paragraphId}/problem/{problemId}/association")
  public ResultVo association(Long datasetId, Long documentId, Long paragraphId, Long problemId) {
    return Aop.get(MossKbProblemService.class).association(datasetId, documentId, paragraphId, problemId);
  }

  @Put("/{datasetId}/document/{documentId}/paragraph/{paragraphId}/problem/{problemId}/un_association")
  public ResultVo unAssociation(Long datasetId, Long documentId, Long paragraphId, Long problemId) {
    return Aop.get(MossKbProblemService.class).unAssociation(datasetId, documentId, paragraphId, problemId);
  }

  @Post("/{datasetId}/problem/_batch")
  public ResultVo addProblems(Long datasetId, HttpRequest request) {
    String bodyString = request.getBodyString();
    ProbrolemCreateBatch batchRequest = JsonUtils.parse(bodyString, ProbrolemCreateBatch.class);
    return Aop.get(MossKbProblemService.class).addProblems(datasetId, batchRequest);
  }

  @Delete("/{datasetId}/problem/{problemId}")
  public ResultVo deleteProblem(Long datasetId, Long problemId) {
    return Aop.get(MossKbProblemService.class).delete(datasetId, problemId);
  }
}服务层实现
package nexus.io.mosskb.service;

import java.util.ArrayList;
import java.util.List;

import com.jfinal.kit.Kv;
import nexus.io.db.TableInput;
import nexus.io.db.TableResult;
import nexus.io.db.activerecord.Db;
import nexus.io.db.activerecord.Row;
import nexus.io.kit.RecordUtils;
import nexus.io.mosskb.constant.TableNames;
import nexus.io.mosskb.model.MossKbParagraphId;
import nexus.io.mosskb.model.ProbrolemCreateBatch;
import nexus.io.mosskb.model.ResultPage;
import nexus.io.model.page.Page;
import nexus.io.model.result.ResultVo;
import nexus.io.table.services.ApiTable;
import nexus.io.tio.utils.snowflake.SnowflakeIdUtils;

public class MossKbProblemService {

  /**
   * 创建问题
   *
   * @param datasetId 数据集ID
   * @param problems  问题内容列表
   * @return 结果VO
   */
  public ResultVo create(Long datasetId, List<String> problems) {
    List<Long> ids = new ArrayList<>();
    List<Row> records = new ArrayList<>();

    for (String string : problems) {
      long id = SnowflakeIdUtils.id();
      records.add(Row.by("id", id)
                        .set("content", string)
                        .set("dataset_id", datasetId)
                        .set("hit_num", 0));
      ids.add(id);
    }

    Db.batchSave(TableNames.moss_kb_problem, records, 2000);
    return ResultVo.ok(ids);
  }

  /**
   * 分页获取问题列表
   *
   * @param datasetId 数据集ID
   * @param pageNo    页码
   * @param pageSize  页大小
   * @return 结果VO
   */
  public ResultVo page(Long datasetId, Integer pageNo, Integer pageSize) {
    TableInput tableInput = TableInput.create()
                                      .setPageNo(pageNo)
                                      .setPageSize(pageSize);
    TableResult<Page<Row>> page = ApiTable.page(TableNames.moss_kb_problem, tableInput);
    int totalRow = page.getData().getTotalRow();
    List<Row> list = page.getData().getList();
    List<Kv> kvs = RecordUtils.recordsToKv(list, false);
    ResultPage<Kv> resultPage = new ResultPage<>(pageNo, pageSize, totalRow, kvs);
    return ResultVo.ok(resultPage);
  }

  /**
   * 批量删除问题
   *
   * @param datasetId 数据集ID
   * @param ids       问题ID列表
   * @return 结果VO
   */
  public ResultVo delete(Long datasetId, List<Long> ids) {
    ApiTable.deleteByIds(TableNames.moss_kb_problem, ids);
    ApiTable.deleteByIds(TableNames.moss_kb_problem_paragraph_mapping, "problem_id", ids);
    return ResultVo.ok();
  }

  /**
   * 删除单个问题
   *
   * @param datasetId 数据集ID
   * @param problemId 问题ID
   * @return 结果VO
   */
  public ResultVo delete(Long datasetId, Long problemId) {
    ApiTable.delById(TableNames.moss_kb_problem, problemId);
    ApiTable.delById(TableNames.moss_kb_problem_paragraph_mapping, "problem_id", problemId);
    return ResultVo.ok();
  }

  /**
   * 根据问题ID列出关联的段落
   *
   * @param datasetId  数据集ID
   * @param problemId 问题ID
   * @return 结果VO
   */
  public ResultVo listParagraphByProblemId(Long datasetId, Long problemId) {
    List<Kv> datas = new ArrayList<>();
    TableInput tableInput = TableInput.by("dataset_id", datasetId)
                                      .set("problem_id", problemId)
                                      .columns("paragraph_id as id");
    TableResult<List<Row>> tableResult = ApiTable.list(TableNames.moss_kb_problem_paragraph_mapping, tableInput);
    List<Row> records = tableResult.getData();
    if (records != null) {
      datas = RecordUtils.recordsToKv(records, false);
    }
    return ResultVo.ok(datas);
  }

  /**
   * 关联问题与段落
   *
   * @param datasetId   数据集ID
   * @param documentId  文档ID
   * @param paragraphId 段落ID
   * @param problemId   问题ID
   * @return 结果VO
   */
  public ResultVo association(Long datasetId, Long documentId, Long paragraphId, Long problemId) {
    long id = SnowflakeIdUtils.id();
    Row row = Row.by("id", id)
                          .set("dataset_id", datasetId)
                          .set("document_id", documentId)
                          .set("paragraph_id", paragraphId)
                          .set("problem_id", problemId);
    boolean save = Db.save(TableNames.moss_kb_problem_paragraph_mapping, row);
    if (save) {
      return ResultVo.ok();
    } else {
      return ResultVo.fail();
    }
  }

  /**
   * 取消关联问题与段落
   *
   * @param datasetId   数据集ID
   * @param documentId  文档ID
   * @param paragraphId 段落ID
   * @param problemId   问题ID
   * @return 结果VO
   */
  public ResultVo unAssociation(Long datasetId, Long documentId, Long paragraphId, Long problemId) {
    Row row = Row.by("dataset_id", datasetId)
                          .set("document_id", documentId)
                          .set("paragraph_id", paragraphId)
                          .set("problem_id", problemId);
    boolean ok = Db.delete(TableNames.moss_kb_problem_paragraph_mapping, row);
    if (ok) {
      return ResultVo.ok();
    } else {
      return ResultVo.fail();
    }
  }

  /**
   * 批量添加问题与段落的关联
   *
   * @param datasetId     数据集ID
   * @param batchRequest 批量请求对象
   * @return 结果VO
   */
  public ResultVo addProblems(Long datasetId, ProbrolemCreateBatch batchRequest) {
    List<MossKbParagraphId> paragraphList = batchRequest.getParagraph_list();
    List<Long> problemIdList = batchRequest.getProblem_id_list();

    List<Row> mappings = new ArrayList<>();
    for (MossKbParagraphId mossKbParagraphId : paragraphList) {
      Long documentId = mossKbParagraphId.getDocument_id();
      Long paragraphId = mossKbParagraphId.getParagraph_id();

      for (Long problemId : problemIdList) {
        long id = SnowflakeIdUtils.id();
        Row row = Row.by("id", id)
                              .set("dataset_id", datasetId)
                              .set("document_id", documentId)
                              .set("paragraph_id", paragraphId)
                              .set("problem_id", problemId);
        mappings.add(row);
      }
    }

    Db.batchSave(TableNames.moss_kb_problem_paragraph_mapping, mappings, 2000);
    return ResultVo.ok();
  }
}关键功能解析
创建问题:
- 接收问题内容列表,通过雪花算法生成唯一 ID,并保存到
moss_kb_problem表中。 - 返回创建成功的所有问题 ID。
- 接收问题内容列表,通过雪花算法生成唯一 ID,并保存到
分页获取问题列表:
- 根据提供的页码和页大小,从
moss_kb_problem表中分页查询问题。 - 返回包含问题详细信息的分页结果。
- 根据提供的页码和页大小,从
关联问题与段落:
- 在
moss_kb_problem_paragraph_mapping表中插入关联记录,实现问题与段落的关联。 - 关联成功返回成功响应,失败则返回失败信息。
- 在
取消关联问题与段落:
- 根据提供的关联信息,从
moss_kb_problem_paragraph_mapping表中删除对应的记录。 - 取消关联成功返回成功响应,失败则返回失败信息。
- 根据提供的关联信息,从
批量添加问题与段落的关联:
- 接收批量问题 ID 和段落列表,生成对应的关联记录,并批量插入到
moss_kb_problem_paragraph_mapping表中。 - 返回操作成功的响应。
- 接收批量问题 ID 和段落列表,生成对应的关联记录,并批量插入到
删除单个问题:
- 根据问题 ID,从
moss_kb_problem表中删除对应的问题记录。 - 同时删除与该问题关联的段落记录,确保数据一致性。
- 返回操作成功的响应。
- 根据问题 ID,从
批量删除问题:
- 接收问题 ID 列表,批量删除
moss_kb_problem表中的问题记录。 - 同时批量删除与这些问题关联的段落记录。
- 返回操作成功的响应。
- 接收问题 ID 列表,批量删除
根据问题 ID 获取关联的段落:
- 根据提供的问题 ID,从
moss_kb_problem_paragraph_mapping表中查询关联的段落 ID。 - 返回关联段落的列表。
- 根据提供的问题 ID,从
前端示例
总结
通过上述问题管理功能的全面实现,系统能够更高效地管理知识库中的问题与片段的关联关系,为大模型推理提供精准的参考依据。这不仅提升了系统的智能化水平,也为用户提供了更加便捷的数据管理工具。